Как правдоподобный AI-код превращается в дорогой технический долг
Как правдоподобный AI-код превращается в дорогой технический долг
Это разбор реального компонента, сгенерированного Opus 4.5 в платной Windsurf/Devis IDE.
Важно не то, что модель написала плохой код. Такое случается с любым разработчиком.
Важно другое: реализация выглядела очень правдоподобно.
Были:
- отдельные hooks;
Play / Pause / Stop;Loop;- timeline;
- keyframes;
- transition types;
- Web Audio API;
- styled UI;
- отчёт с чекбоксами
[x].
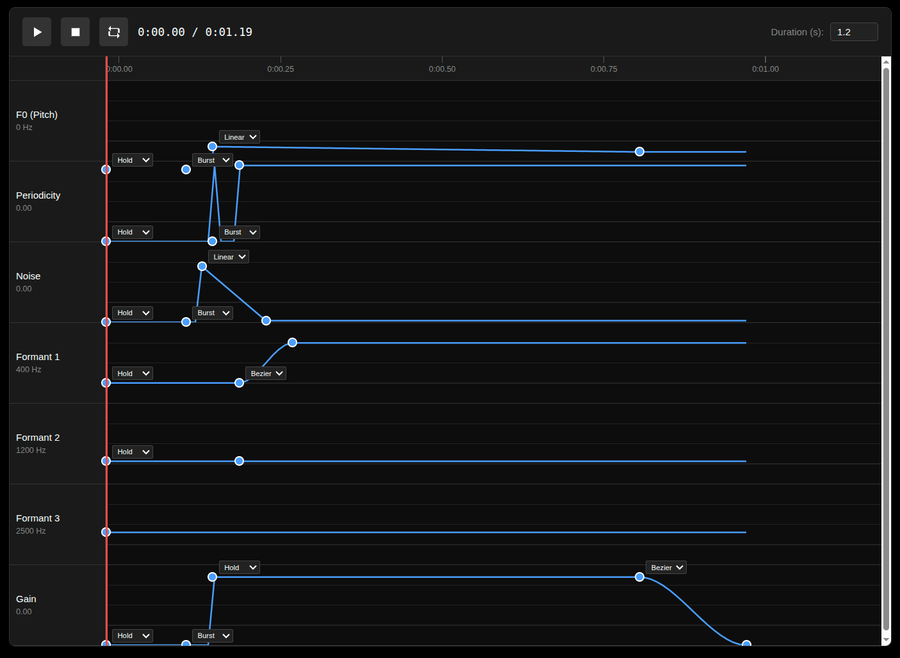
То есть со стороны это легко принять за «почти готовый компонент, осталось немного допилить».
На практике компонент пришлось признать непригодным и решить переписать с нуля.
Это хороший пример того, почему при AI-разработке цена ошибки зависит не только от качества модели, но и от компетенции человека, который принимает архитектурные решения.
Связанный более общий разбор организационного риска: «Когда оптимизм ИИ становится бизнес-риском».
Задача
Нужна была простая лаборатория для ручных экспериментов со звуком:
- двигать параметры по временной шкале;
- включать loop;
- слышать результат;
- искать хотя бы простые узнаваемые речеподобные звуки;
- сохранять удачные конфигурации для дальнейшего анализа.
То есть цель была не «написать production TTS», а проверить более простой вопрос:
можно ли вручную нащупать полезные акустические состояния?
Для этого особенно важны две вещи:
- звук должен воспроизводиться предсказуемо;
- временная логика UI должна точно соответствовать реально сгенерированному аудио.
Именно этого в реализации не получилось.
1. Главная проблема: звук строился не как детерминированный сигнал
В компоненте аудио создавалось как живой граф Web Audio nodes, а параметры обновлялись во время playback.
Упрощённо архитектура выглядела так:
const mainOsc = ctx.createOscillator()
mainOsc.type = 'sawtooth'

const formant1 = ctx.createBiquadFilter()
const formant2 = ctx.createBiquadFilter()
const formant3 = ctx.createBiquadFilter()

mainOsc.connect(formant1)
formant1.connect(formant2)
formant2.connect(formant3)
formant3.connect(mainGain)
mainGain.connect(ctx.destination)
А затем UI регулярно менял параметры уже работающего графа:
mainOscillatorRef.current.frequency.setTargetAtTime(
  values.f0,
  currentTime,
  0.02,
)

formant1Ref.current.frequency.setTargetAtTime(
  values.formant1,
  currentTime,
  0.02,
)
Для музыкального контроллера такой подход может быть приемлем.
Для нашей задачи лучше другая модель:
for (let i = 0; i < sampleCount; i++) {
  const t = i / sampleRate
  const state = getValuesAtTime(t)

  output[i] = synthesizeSample(state, internalState)
}
Сначала строится весь PCM:
const output = new Float32Array(sampleCount)
И только потом он передаётся в AudioBuffer и воспроизводится.
Почему это важно:
- 5 ms остаются 5 ms, а не зависят от browser FPS;
- loop повторяет тот же сигнал;
- seek работает по конкретному массиву;
- waveform, spectrum и логи анализируют тот же звук, который слышит пользователь;
- один сценарий можно сделать бит-в-бит воспроизводимым.
Иными словами, для лаборатории хотелось иметь функцию:
Scenario -> Float32Array
а AudioContext использовать почти только как проигрыватель.
Это не значит, что Web Audio automation сама по себе плоха. Проблема в том, что в данной архитектуре логика синтеза оказалась распределена между React, browser scheduler и внутренним состоянием Web Audio nodes.
После этого отладить причинность становится намного сложнее.
2. Форманты были соединены так, что периодический сигнал почти уничтожался
Код:
mainOsc.connect(formant1)
formant1.connect(formant2)
formant2.connect(formant3)
formant3.connect(mainGain)
Все три фильтра — bandpass:
formant1.type = 'bandpass'
formant1.Q.value = 10

formant2.type = 'bandpass'
formant2.Q.value = 10

formant3.type = 'bandpass'
formant3.Q.value = 10
Допустим:
F1 = 400 Hz
F2 = 1200 Hz
F3 = 2500 Hz
Что делает схема:
sawtooth
  ↓
оставить в основном ~400 Hz
  ↓
из этого оставить в основном ~1200 Hz
  ↓
из этого оставить в основном ~2500 Hz
  ↓
почти ничего
Три форманты речи существуют одновременно. Если моделировать их тремя узкими фильтрами, то естественнее хотя бы начать с параллельных веток:
             ┌→ F1 → gain1 ┐
source ──────┼→ F2 → gain2 ├→ SUM → output
             └→ F3 → gain3 ┘
Уже эта ошибка объясняет, почему большая часть «гласных» практически не звучала.
И это не UI-баг, который можно быстро «допилить». Это ошибка в самой акустической модели.
3. Почему при этом хорошо слышался шум
Шум шёл совершенно другим путём:
noiseSource.connect(noiseGainRef.current)
noiseGainRef.current.connect(ctx.destination)
То есть:
noise -> gain -> speakers
Он вообще обходил formant chain.
В результате периодическая часть почти убивалась последовательными фильтрами, а белый шум доходил до выхода напрямую.
Поэтому наблюдение «из заготовок слышно в основном С» оказалось не подтверждением удачного синтеза С, а ожидаемым следствием routing.
Это хороший пример того, как результат может выглядеть содержательно, хотя на самом деле объясняется технической случайностью.
4. requestAnimationFrame использовался как scheduler DSP
Критический фрагмент:
const audioLoop = useCallback(() => {
  const elapsed = (performance.now() - startTimeRef.current) / 1000
  updateAudioParams(elapsed)

  animationFrameRef.current = requestAnimationFrame(audioLoop)
}, [updateAudioParams])
То есть параметры звука обновлялись примерно с частотой отрисовки браузера.
Обычно это около 60 Hz:
1000 / 60 ≈ 16.7 ms
А теперь представим burst длиной 5 ms:
|---- frame ----|---- frame ----|
      [burst]
Он может целиком попасть между двумя вызовами callback.
Потом поверх этого ещё применяется:
const smoothTime = 0.02
то есть сглаживание около 20 ms.
В итоге короткое акустическое событие может:
- не попасть в scheduler;
- затем дополнительно размазаться smoothing-ом.
Для кнопочной анимации это нормально.
Для речевого DSP — нет.
requestAnimationFrame должен двигать playhead на экране. Он не должен определять точность синтеза.
5. UI и звук жили на разных часах
UI имел собственный playback:
const { currentTime, isPlaying, play, pause, stop, seek } = usePlayback({
  duration,
  isLooping,
})
А звук вычислял время отдельно:
const elapsed =
  (performance.now() - startTimeRef.current) / 1000
Это две независимые временные системы.
Поэтому UI мог сделать:
0.0 -> 1.0 -> 2.0 -> LOOP -> 0.0
а audio hook продолжить:
0.0 -> 1.0 -> 2.0 -> 3.0 -> 4.0
То же самое с seek: playhead перескакивает, но audio hook про этот seek вообще ничего не знает.
Для лаборатории это критично. Если исследователь видит курсор в 320 ms, он должен слышать 320 ms того же сценария, а не просто какой-то звук из другой временной системы.
6. Второй Play не работал, а Stop мог снова запустить звук
Это уже было видно без анализа кода — просто руками.
Первый Play работал.
Второй — нет.
Нажимаешь Stop — и в некоторых состояниях звук снова появляется.
В коде причина вполне просматривается.
Основной oscillator создаётся один раз:
const mainOsc = ctx.createOscillator()
mainOsc.start()
А stopAudio() его не останавливает. Вместо этого уменьшается gain:
mainGainRef.current.gain.setTargetAtTime(
  0,
  audioContextRef.current.currentTime,
  0.05,
)
То есть Stop на самом деле означает не «остановить источник», а «попытаться сделать его тихим».
С noise source ещё хуже:
setTimeout(() => {
  try {
    noiseSourceRef.current?.stop()
  } catch {}

  noiseSourceRef.current = null
}, 100)
Представим последовательность:
T0: Stop старого source A
T1: запланирован timeout на +100 ms
T2: пользователь снова нажал Play
T3: noiseSourceRef теперь указывает уже на новый source B
T4: старый timeout срабатывает
T5: останавливает B
Callback был создан для старого источника, но читает текущий ref.
Это обычная race condition.
Такой баг можно исправить локально:
const sourceToStop = noiseSourceRef.current

setTimeout(() => {
  sourceToStop?.stop()
}, 100)
Но здесь важно другое: когда подобных проблем много, локальные фиксы начинают маскировать фундаментально плохую модель состояния.
7. Вместо конечного автомата получился зоопарк refs и states
Одно понятие — playback — оказалось размазано по множеству сущностей:
isPlaying
isLooping
currentTime
duration
startTimeRef
audioContextRef
mainOscillatorRef
noiseSourceRef
mainGainRef
noiseGainRef
formant1Ref
formant2Ref
formant3Ref
animationFrameRef
Плюс setTimeout, плюс внутреннее состояние AudioContext, плюс отдельный usePlayback.
Локально каждый ref выглядит разумно.
Глобально никто не владеет состоянием системы.
Для такого компонента гораздо полезнее единый reducer:
type PlaybackState = {
  mode: 'stopped' | 'playing' | 'paused'
  position: number
  duration: number
  loop: boolean
  renderRevision: number
}
И события:
type Action =
  | { type: 'PLAY' }
  | { type: 'PAUSE' }
  | { type: 'STOP' }
  | { type: 'SEEK'; position: number }
  | { type: 'TOGGLE_LOOP' }
  | { type: 'SCENARIO_CHANGED' }
  | { type: 'RENDER_READY' }
  | { type: 'PLAYBACK_ENDED' }
Тогда хотя бы существует одно место, где можно ответить на вопрос:
что означает
STOP?
Например:
case 'STOP':
  return {
    ...state,
    mode: 'stopped',
    position: 0,
  }
А побочные эффекты уже обслуживают это состояние, а не создают параллельные версии истины.
8. periodicity называлась не так, как реально работала
В коде:
const periodicGain = values.gain * values.periodicity
И отдельно:
const noiseLevel = values.gain * values.noise * 0.3
Это значит, что можно одновременно поставить:
periodicity = 1
noise = 1
И оба источника будут работать на максимуме.
То есть periodicity фактически означает не «насколько сигнал периодический», а что-то ближе к:
periodicSourceLevel
Это мелочь по сравнению с проблемами выше, но для исследовательского UI семантика названий очень важна.
Пользователь должен понимать, какую математику он меняет.
9. hold/linear/bezier и burst/noise/sine смешали разные уровни модели
В UI всё было названо transition type.
Но:
hold
linear
bezier
отвечают на вопрос:
как перейти между двумя keyframes?
А:
sine
burst
noise
отвечают уже на другой вопрос:
какую функцию наложить на участок времени?
Это скорее modulators.
Более чистая модель:
value(t) = envelope(t) + modulator(t)
Например:
baseline F0
+ sine vibrato
или:
steady pressure
+ short burst
Опять же, сама по себе эта ошибка не убивает компонент. Но она показывает, что модель данных начала усложняться раньше, чем была доказана базовая работоспособность звука.
Почему мы не стали это «допиливать»
Технически почти каждую проблему выше можно исправить отдельно.
Можно:
- переделать routing фильтров;
- исправить race condition;
- синхронизировать clocks;
- заменить scheduler;
- поправить naming;
- перестроить lifecycle;
- переделать transition model.
Но после этого останется вопрос:
зачем сохранять сложную кодовую базу, построенную вокруг неправильной базовой архитектуры?
Каждый такой фикс увеличивает объём кода, который потом нужно понимать, тестировать и поддерживать.
Это классический момент, где опытный инженер должен уметь сказать:
не чинить. выбросить. переписать минимальную основу.
Новая схема может быть намного проще:
UI
 ↓
Scenario / keyframes
 ↓
Deterministic renderer
 ↓
Float32Array
 ↓
AudioBuffer
 ↓
Playback
И отдельно:
Float32Array
 ├→ waveform
 ├→ spectrum
 ├→ logs
 └→ export
Один и тот же массив становится источником истины.
Самая опасная часть: код был похож на хороший
Если бы компонент вообще не запускался, проблема была бы дешёвой.
Но он запускался.
UI выглядел правдоподобно.
Кнопки были.
Hooks были разложены по файлам.
В отчёте стояли галочки:
[x] Play/Pause/Stop
[x] Loop
[x] Audio synthesis
[x] Timeline
Именно такой AI-код наиболее опасен.
Он не выглядит мусором.
Он выглядит как система, которую осталось немного довести.
Чтобы увидеть, что основание системы плохое, разработчик должен одновременно понимать:
- React lifecycle;
- state machines;
- race conditions;
- Web Audio;
- временную дискретизацию;
- основы DSP;
- архитектурную стоимость дальнейшего усложнения.
То есть AI не отменяет высокую инженерную квалификацию. В таких случаях он делает её ещё важнее.
Потому что скорость генерации кода увеличилась, а значит плохую архитектуру теперь можно нарастить намного быстрее.
Почему организационная структура резко меняет цену ошибки
Здесь этот кейс напрямую пересекается с топиком «Когда оптимизм ИИ становится бизнес-риском».
В моём случае вертикаль принятия решения минимальна.
Я увидел фактическое поведение:
второй Play сломан
Stop ведёт себя нелогично
звук плохой
архитектура расползается
Посмотрел код и могу в тот же момент принять решение:
переписываем с нуля.
Стоимость ошибки — несколько часов или дней эксперимента.
Теперь представим обычную компанию.
Агент выдаёт красивый отчёт.
Разработчик сделал компонент.
Задача закрыта на 80%.
Дальше инженер говорит:
это надо выбросить.
И тут начинаются вопросы:
- Почему выбросить?
- Мы же уже заплатили за разработку.
- Нельзя ли просто исправить Play?
- А если ещё неделю допилить?
- Кто согласовал первоначальную архитектуру?
- Почему в отчёте всё было готово?
- Нужно ли переносить сроки?
- Кто объяснит это менеджеру?
- Кто объяснит менеджеру менеджера?
И вместо дешёвого решения:
delete -> rewrite
организация начинает защищать уже сделанную работу.
Появляется sunk cost.
Потом поверх плохого основания добавляют:
- ещё hooks;
- ещё flags;
- ещё refs;
- ещё effects;
- ещё special cases;
- ещё тесты на обход старых багов.
Через несколько недель переписывать уже психологически и финансово намного сложнее.
Ошибка, которую один человек мог закрыть за день, превращается в десятки тысяч долларов зарплат, менеджмента и потери времени.
Именно поэтому формула из предыдущего топика здесь проявляется буквально:
стоимость технической ошибки
×
организационная инерция
Практический вывод
Нельзя оценивать AI-код по количеству файлов, hooks, abstraction layers и закрытых чекбоксов.
Нужно сначала проверить несколько фундаментальных инвариантов.
Для этого компонента они могли быть совсем короткими:
Play -> звук
Stop -> полная тишина
Play снова -> звук снова
Loop -> повторяется тот же сценарий
Seek -> слышно именно выбранное место
5 ms event -> реально существует в выходном сигнале
один scenario -> один и тот же PCM
Если эти проверки не проходят, не нужно обсуждать polish UI и дополнительные features.
Нужно проверять архитектуру.
И иногда наиболее профессиональное решение — не «исправить ещё несколько багов», а вовремя признать:
этот код слишком похож на рабочий, чтобы его было безопасно продолжать. Его дешевле удалить и написать правильную минимальную основу заново.