Как мы сделали сайт для обучения чтению из React-карточек, Web Speech API и двух кнопок
Как мы сделали сайт для обучения чтению из React-карточек, Web Speech API и двух кнопок
Когда мы начали делать «Учиться легко», задача выглядела почти слишком простой для отдельного технического проекта.
Есть картинка.
Есть слово.
Есть слоги.
Есть буквы.
Нажимаешь — браузер произносит выбранный элемент.
Например:
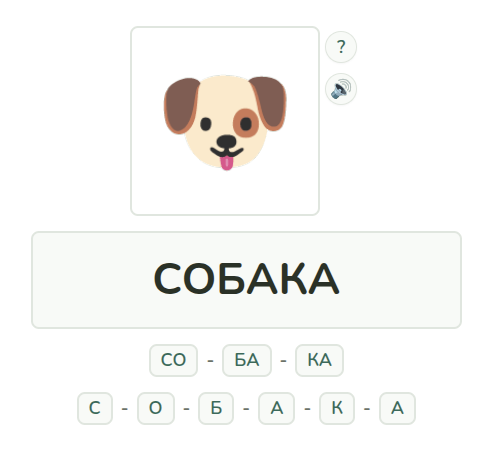
На первый взгляд здесь почти нечего программировать.
Но после первых работающих прототипов выяснилось, что интересная часть проекта находится как раз не в количестве кода, а в том, какую информацию показывать ребёнку, в каком виде и какую обратную связь давать на каждое действие.
За несколько дней простая карточка превратилась в небольшой экспериментальный интерфейс для исследования письменной речи.
В этой статье разберём, как он устроен технически, какие проблемы неожиданно возникли с браузерным TTS и что показали первые наблюдения за детьми.
Работа над MVP ведётся в открытой задаче «Собрать браузерный прототип минимального MVP».
С чего всё началось
Исходная идея была простой.
Ребёнок уже знает, что изображено на картинке.
Например, видит собаку.
Он также знает, как произносится слово «собака».
Но письменная форма для него ещё может быть неизвестной.
Поэтому вместо начала с абстрактной буквы мы показываем сразу несколько представлений одного объекта:
🐶
СОБАКА
СО-БА-КА
С-О-Б-А-К-А
Каждый элемент можно нажать и услышать.
Получается простая интерактивная связь:
знакомый объект
      ↓
знакомое звучание
      ↓
написанное слово
      ↓
слоги
      ↓
буквы
Для первой версии этого оказалось достаточно обычного массива данных.
Примерно такого:
export interface PronounceCard {
  emoji: string
  text: string
  description: string
  lines: {
    parts: string[]
  }[]
}
И сама карточка:
{
  emoji: '🐶',
  text: 'СОБАКА',
  description:
    'Собака — домашнее животное. Она может жить рядом с человеком, охранять дом и играть.',
  lines: [
    { parts: ['СО', 'БА', 'КА'] },
    { parts: ['С', 'О', 'Б', 'А', 'К', 'А'] },
  ],
}
То есть никаких нейросетей, сложной LMS или отдельного backend для первого рабочего варианта не понадобилось.
Озвучивание через браузер
Самый очевидный способ заставить карточки говорить — Web Speech API.
В браузере уже есть:
window.speechSynthesis
Поэтому базовая функция получилась буквально в несколько строк:
const utterance = new SpeechSynthesisUtterance(text)

utterance.lang = 'ru-RU'
utterance.rate = 0.8
utterance.pitch = 1.3

window.speechSynthesis.speak(utterance)
Мы специально немного снизили скорость речи и подняли высоту голоса.
Для ребёнка такой голос оказался приятнее обычного системного чтения.
Для целых слов всё выглядело довольно хорошо.
Например:
СОБАКА
КОШКА
РЫБА
СВИНЬЯ
браузер обычно произносил ожидаемо.
И здесь казалось, что задача практически решена.
Но затем мы начали нажимать на слоги.
Работа над браузерной озвучкой вынесена в отдельную задачу: «Добавить браузерную озвучку букв, слогов и отдельных слов».
SpeechSynthesis умеет читать текст, но не обязан понимать ваши слоги
Вот здесь Web Speech API преподнёс первый сюрприз.
Строка:
Собака
произносится нормально.
Но если отправить:
Со
конкретный системный голос может произнести не тот слог, который ожидается.
С другими частями слов получилось ещё интереснее.
Например:
СВИНЬ
один из протестированных движков начинал воспринимать почти как последовательность названий букв.
Похожие проблемы возникали с:
КОВЬ
СОЛН
То есть для браузера наши слоги — не слоги.
Для него это просто короткие строки, которые он самостоятельно пытается интерпретировать как:
- слово;
- сокращение;
- букву;
- неизвестную лексему;
- последовательность символов.
И никакого образовательного контекста у TTS, разумеется, нет.
На iPhone появилась ещё одна особенность
Отдельный интересный случай обнаружился на iOS.
Если отправить в SpeechSynthesis одиночную заглавную букву:
Б
системный голос может сказать:
«Заглавная буква Б».
Для обычного screen reader это вполне разумное поведение.
Для нашей карточки — совершенно неподходящее.
При этом:
'Б'.toLowerCase()
могло произноситься уже так, как нам нужно.
Поэтому визуальное представление и значение для TTS пришлось разделить.
На экране:
Б
В синтезатор:
б
Это маленькая техническая деталь, но хороший пример того, насколько быстро заканчивается простая модель:
«Возьмём текст и отдадим его браузеру».
Почему мы пока всё равно оставили браузерный TTS
У проекта уже есть отдельное направление на более управляемый голосовой pipeline.
Потому что в долгосрочной перспективе для букв и слогов нужен звук, который воспроизводится одинаково и предсказуемо.
Варианты понятны:
готовые записи
собственный TTS
SSML
словарь исключений
гибридная система
Но для MVP браузерный синтез оказался очень полезным.
Он позволил практически без инфраструктуры проверить более важный вопрос:
будет ли ребёнок вообще пользоваться такой механикой так, как мы предполагаем?
Это хороший случай, когда технически несовершенное решение лучше идеальной архитектуры, которой ещё нет.
Первые дети быстро поняли интерфейс без инструкции
И вот здесь проект стал интереснее уже не только технически.
Одна из опасностей была очевидной.
Если любой элемент издаёт звук, ребёнок может просто превратить интерфейс в звуковую игрушку:
тык
тык
тык
тык
Но в первых наблюдениях происходило другое.
Ребёнок сначала пытался распознать элемент самостоятельно, а затем использовал звук как проверку:
попытался прочитать
        ↓
нажал
        ↓
услышал
        ↓
сравнил
        ↓
пошёл дальше
Причём специального onboarding для этого не потребовалось.
Дети достаточно быстро понимали:
- можно нажать слово;
- можно нажать слог;
- можно нажать букву;
- каждый уровень что-то даёт.
Один шестилетний ребёнок самостоятельно прошёл весь доступный набор.
Позже похожее поведение наблюдалось ещё у одного ребёнка, который уже свободно читает: предполагалось, что простой материал ему быстро наскучит, но он тоже прошёл доступные карточки целиком.
Это пока не исследование и не статистически значимый эксперимент.
Но для MVP этого достаточно, чтобы понять: интерфейс не разваливается при встрече с реальным ребёнком.
Наблюдения и дальнейшая проверка поведения пользователей фиксируются в связанной задаче «Проработать маркетинг и позиционирование», где сейчас накапливаются реальные кейсы использования.
А потом обнаружилась логическая дыра
Первая версия опиралась на скрытое предположение:
ребёнок знает, что изображено на картинке.
Для собаки это обычно работает:
🐶 → «собака»
Но что будет, если показать ленивца?
Ребёнок может:
- не знать его названия;
- не знать, что это вообще за животное.
Причём это две разные проблемы.
Знать, что слово произносится как:
ленивец
и знать, что такое ленивец, — не одно и то же.
И здесь из довольно маленького UX-вопроса появилась новая механика.
Её обоснование и текущая реализация отдельно описаны в новости проекта: «На “Учиться легко” появились кнопки “Что это?” и озвучивание».
Две универсальные кнопки: «как звучит?» и «что это?»
Теперь рядом с сущностью есть две независимые кнопки:
? 🔊
Динамик отвечает:
Как это звучит?
Вопросительный знак:
Что это такое?
То есть карточка теперь выглядит примерно так:
🐶

? 🔊

СОБАКА

СО-БА-КА

С-О-Б-А-К-А
Это оказалось важным разделением.
Потому что один ребёнок может знать собаку полностью.
Другой знает животное, но не его название.
Третий слышал слово, но не понимает значение.
Четвёртый впервые видит и объект, и слово.
Приложению не требуется заранее знать, какой именно вариант перед ним.
Ребёнок сам выбирает нужный инструмент.
Эта механика уже реализована в задаче «Внедрить универсальную механику “Что это?” и озвучивания сущностей».
Что происходит после нажатия «?»
Мы не стали сразу запускать голосовое объяснение.
Это важно.
После нажатия ? открывается та же карточка, но появляется короткое описание:
Ленивец — зверь, который живёт на деревьях в тёплых лесах. Он цепляется за ветки длинными когтями и часто висит спиной вниз.
У самого описания есть свой динамик.
То есть пользователь отдельно решает:
хочу увидеть объяснение
и:
хочу услышать объяснение
Так интерфейс не начинает внезапно читать длинный текст только потому, что ребёнок случайно нажал кнопку.
Самое интересное получилось с подсветкой текста
Когда описание произносится, фон текста постепенно движется вслед за голосом.
Это похоже на очень простой karaoke/highlight режим.
Условно:
Ленивец → живёт → на → деревьях
Ребёнок слышит речь и одновременно видит, какая часть текста сейчас звучит.
И здесь появилась механика, которую мы изначально вообще не проектировали.
Ребёнку не обязательно объяснять, что предложение состоит из слов
Представим ребёнка, который ещё вообще не понимает устройство письменной речи.
Для него:
Ленивец живёт на деревьях.
может быть просто последовательностью странных символов.
Но затем он нажимает динамик.
Слышит:
«Ленивец живёт на деревьях».
И видит, как подсветка последовательно проходит по написанному.
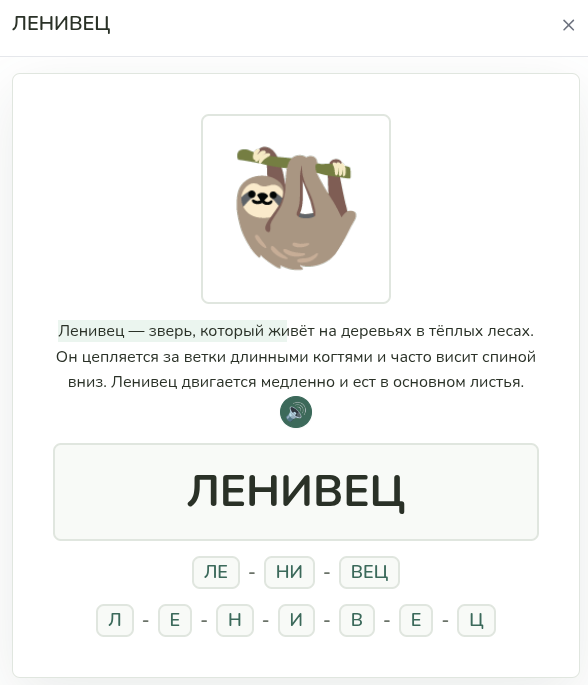
После нескольких повторений становится наблюдаемой связь:
звучащая речь
      ↕
написанный текст
А затем каждое слово можно нажать отдельно.
Нажал:
живёт
услышал:
«живёт».
Нажал:
деревьях
услышал:
«деревьях».
Никто ещё не говорил ребёнку:
«Предложение состоит из слов».
Но сам интерфейс позволяет это обнаружить.
Именно отсюда выросло следующее направление разработки — «Проработать второй уровень освоения письменности: чтение предложений и пунктуация».
Получилась вложенная структура
Текущую систему теперь можно представить так:
описание
   ↓
предложение
   ↓
слово
   ↓
слог
   ↓
буква
И практически каждый уровень можно услышать.
Это интересно именно с точки зрения разработки интерфейса.
Обычно образовательное приложение явно кодирует сценарий:
урок 1
→ выполнить
→ следующий экран
→ урок 2
→ тест
Здесь структура другая.
Все уровни доступны почти одновременно, а пользователь сам углубляется туда, где ему сейчас чего-то не хватает.
Поэтому технически простая карточка начинает работать больше как небольшой browser знаний, чем как линейный урок.
Почему мы не стали делать систему уровней сложности
Один из первоначальных вариантов мог бы выглядеть так:
3 года → режим A
4 года → режим B
5 лет → режим C
умеет читать → режим D
Но это сразу требует классифицировать ребёнка.
А реальное знание не настолько линейно.
Один и тот же ребёнок может:
- знать слово «собака»;
- не знать «ленивец»;
- прекрасно узнавать некоторые буквы;
- путаться в других;
- читать короткие слова;
- не понимать длинное предложение.
Поэтому вместо:
difficulty = 3
мы фактически пошли к другому интерфейсу:
не знаешь звучание → 🔊
не знаешь значение → ?
хочешь разобрать слово → нажми слово
хочешь разобрать слог → нажми слог
То есть уровень определяется не настройкой приложения, а конкретным действием пользователя.
Технически всё пока остаётся очень маленьким
Что особенно нравится в этом эксперименте: для большинства описанного не нужен сложный стек.
Основная часть текущей реализации — это обычные:
- React-компоненты;
- TypeScript;
- массив данных;
SpeechSynthesisUtterance;- состояния интерфейса;
- события воспроизведения;
- CSS-анимация/transition для отображения процесса речи.
Условный card model всё ещё помещается в несколько полей:
interface PronounceCard {
  emoji: string
  text: string
  description: string
  lines: {
    parts: string[]
  }[]
}
А пользователь уже может пройти путь:
🐶
↓
СОБАКА
↓
СО-БА-КА
↓
С-О-Б-А-К-А
или открыть:
?
↓
описание
↓
🔊
↓
синхронно звучащий текст
↓
отдельные слова
То есть количество интерфейсных возможностей растёт быстрее количества технических сущностей.
Для MVP это очень удобное свойство.
Что оказалось сложнее самого React
Пока наиболее неприятной технической частью оказался не frontend.
Им оказался звук.
Web Speech API прекрасно подходит, если задача звучит:
прочитай эту фразу.
Но намного хуже подходит для:
произнеси вот этот искусственно выделенный русский слог именно так, как его должен услышать ребёнок.
Отсюда уже выросли отдельные технические направления проекта:
- контролируемый TTS;
- подготовленное аудио;
- голосовые персонажи;
- настройка скорости и высоты голоса;
- исследование произношения букв и слогов на разных устройствах.
Мы даже отдельно исследовали процедурный синтез речи через Web Audio, но это оказалось существенно более сложной инженерной задачей, чем казалось первоначально.
То есть интерфейс карточек оказался простым.
А фраза:
«пусть каждая часть слова просто правильно произносится»
довольно быстро открыла отдельную область разработки.
Что показал MVP к текущему моменту
Пока можно говорить только о ранних наблюдениях, а не о доказанной эффективности методики.
Но несколько технических и продуктовых гипотез уже пережили столкновение с реальными пользователями.
Дети:
- понимают базовую механику почти без объяснений;
- самостоятельно выбирают слово, слоги и буквы;
- используют озвучивание не только как игрушку;
- могут проходить весь доступный материал;
- продолжают исследование без системы очков и наград.
Особенно интересно, что механика вызвала интерес и у ребёнка, который уже умеет свободно читать.
Это намекает, что интерактивное разложение информации может оказаться шире первоначальной задачи «научить читать».
Но это уже следующая гипотеза, которую надо проверять отдельно.
Что будем делать дальше
В проекте сейчас параллельно существуют несколько направлений.
Первое — довести звук до предсказуемого состояния. За этим можно следить в задаче по браузерной озвучке.
Второе — продолжать проверять реальное поведение детей и перенос механики на разные уровни знания. Текущие наблюдения фиксируются в задаче по позиционированию и пользовательским кейсам.
Третье — расширять текущую структуру от отдельных слов к предложениям и пунктуации. Это отдельная задача второго уровня письменности.
Четвёртое — развивать универсальную механику:
🔊 = как это звучит
? = что это такое
Её текущая реализация описана и в задаче разработки, и в отдельной публикации «Учиться легко».
Рабочая версия уже доступна на учиться-легко.рф.
И на данный момент это, пожалуй, главный вывод проекта с инженерной точки зрения:
иногда для проверки довольно большой идеи не требуется большая система.
Несколько React-компонентов, браузерный API и правильно выбранные связи между элементами информации уже позволяют построить MVP, на котором можно наблюдать реальное поведение пользователя.
А после этого становится намного проще решать, что действительно стоит усложнять дальше.